Сравнение
GPT-6.1 Sol vs Claude Opus 5.5: бенчмарки и цена
Сравниваем GPT-6.1 Sol и Claude Opus 5.5 по кодовым бенчмаркам, Agent Arena и тарифам в coin: методики тестов, цена задачи и выбор API.
Claude Opus 5.5 выше в Terminal-Bench 4.0 и FrontierCode 2.0 у Artificial Analysis в режиме Max. У GPT-6.1 Sol ниже обычный тариф на API Hubs: расчётная задача с 20 000 входных и 2 000 выходных токенов без кеша стоит 0,054 coin против 0,144 coin. Для сложного исправления проверьте Opus, а экономику Sol оценивайте с учётом всех оплаченных попыток.
Что показывают опубликованные бенчмарки?
Источник таблицы — Artificial Analysis, проверено 5 ноября 2026 года. Конфигурации: GPT-6.1 Sol — Max, Claude Opus 5.5 — Max, Default Fallback. Сохраняем обозначение fallback из источника: это часть измеренной конфигурации, которую нельзя автоматически приравнять к нашему API.
| Метрика и единица | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index v5.0.1 · баллы | 55 | 59 |
| Terminal-Bench 4.0 · % | 56,1 | 59,6 |
| FrontierCode 2.0 · % | 40,6 | 46,4 |
| GDP.pdf · % | 31,0 | 26,2 |
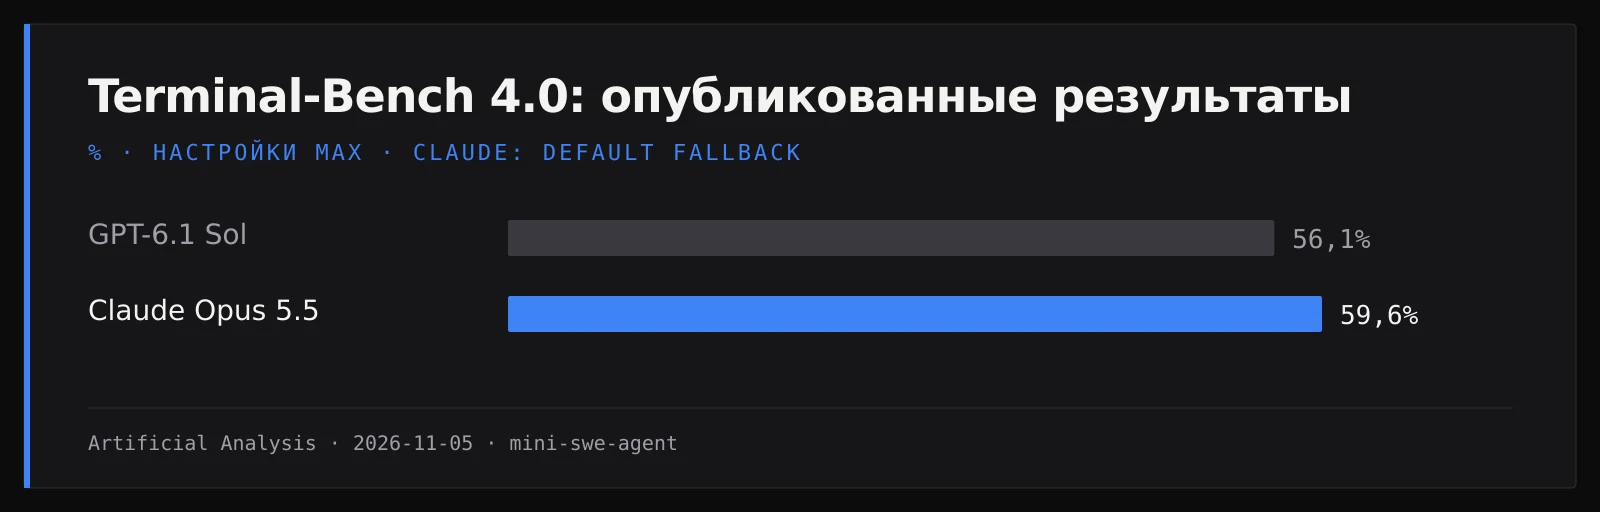
Terminal-Bench 4.0 проверяет работу в терминале: 66 задач, mini-swe-agent, три повтора, средний pass@1; для зачёта должны пройти все проверки. FrontierCode 2.0 использует 132 задачи, три попытки и Stirrup: оценка учитывает скрытые тесты и рубрику с LLM-судьёй. Проценты этих двух тестов измеряют разные задания и способы оценки.
Методика Intelligence Index v5.0.1 объединяет девять оценок: баллы индекса не означают процент правильных ответов. Max обозначает максимальный режим конкретной модели, а не одинаковый бюджет вычислений. В таблице сохранено округление источника; доверительные интервалы отдельных результатов и точные даты запусков на странице сравнения не приведены. Дата выше — дата проверки публикации.
GDP.pdf проверяет ответы по длинным PDF: 100 задач, пять повторов и оценка по рубрике с LLM-судьёй; All-pass требует выполнения всех пунктов рубрики. Это отдельная проверка работы с документами, а не кодовый pass@1.
Opus выше в двух кодовых тестах, Sol — в GDP.pdf. Для исправлений в репозитории это основание включить Opus в пробу; для работы с документами нельзя переносить его преимущество из терминала на все задачи. Эти внешние результаты не измеряют качество русскоязычных ответов или скорость на API Hubs.
Что добавляет Agent Arena?
Agent Arena, таблица от 4 ноября 2026 года, даёт отдельную оценку на реальных сессиях:
| Модель | Net Improvement, п. п. · оценка ± полуширина 95% ДИ | Сессии |
|---|---|---|
| GPT-6.1 Sol (Max) | 12,51 ± 1,11 | 30 285 |
| Claude Opus 5.5 (Max) | 20,14 ± 2,09 | 14 169 |
Методика Arena оценивает эффект выбора модели по сигналам сессий с рандомизацией компонентов. Net Improvement — оценка эффекта, а не доля выполненных задач. Не складывайте её с процентами Terminal-Bench.
Opus имеет более высокую оценку на этой выборке сессий; переносить величину разницы на ваши задачи без проверки нельзя. Это внешние измерения, а не тест API Hubs или его маршрутизации. Снимок цифр и условий позволяет проверить таблицы позднее.
Сколько стоит одинаковая задача в coin?
Каталог проверен 5 ноября 2026 года. Ниже цены API Hubs в coin за миллион токенов, отдельно от прямых тарифов разработчиков и стоимости чужих тестов.
| Вид токенов | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Вход без кеша | 1,80 | 4,80 |
| Выход | 9,00 | 24,00 |
| Чтение кеша | 0,18 | 0,24 |
| Запись кеша | 2,25 | 6,00 |
Зададим одинаковый расход: 20 000 входных без кеша и 2 000 оплачиваемых выходных токенов. Для Sol: 0,02 × 1,80 + 0,002 × 9 = 0,054 coin. Для Opus: 0,02 × 4,80 + 0,002 × 24 = 0,144 coin. Тысяча таких запросов — 54 и 144 coin.
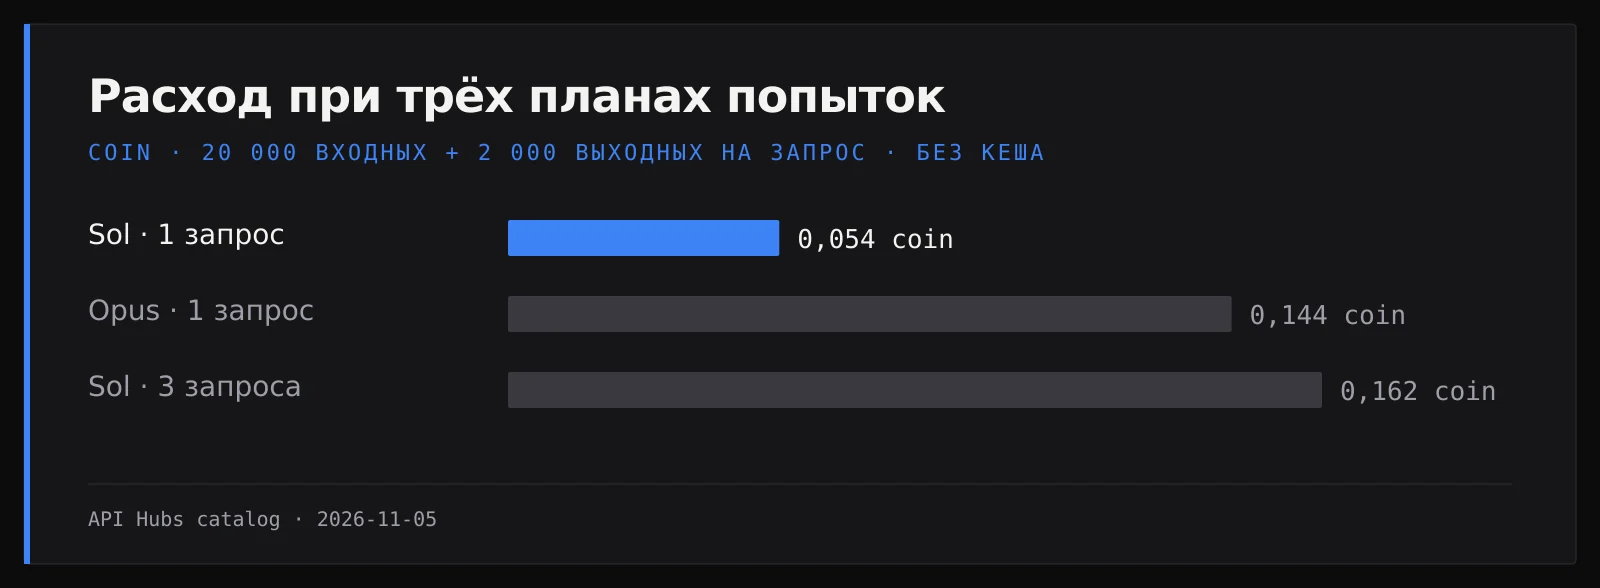
Три попытки Sol по этому условному объёму стоят 0,162 coin — больше одной попытки Opus. Это пример арифметики, а не измеренное число попыток. В рабочем сравнении запишите оплаченные токены рассуждений, отклонённые исправления и повторы. Бенчмарк не сообщает, сколько будет стоить ваш конкретный баг.
Как считать длинный контекст и кеш?
После 272 000 входных токенов каталог указывает для Sol повышенные ставки: 3,60 coin за миллион входных и 15,75 за миллион выходных. Условные 300 000 входных и 10 000 выходных без кеша дают 1,2375 coin. Для Opus те же объёмы по указанным ставкам дают 1,68 coin; отдельного тарифа длинного контекста у него в снимке нет. Приём большого запроса нужно проверить отдельно.
Чтение кеша и его создание считайте по фактическому usage. Повторённый текст сам по себе не гарантирует попадание в кеш. Снимок тарифов сохраняет исходные ставки. Перед серией задач проверьте актуальные цены; фиксированный курс coin к рублю в расчёт не заложен.
Как подключить обе модели к приложению?
Sol и Opus 5.5 доступны через OpenAI Chat Completions. Для Opus каталог также указывает Anthropic Messages.
| Подключение | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| ID в сервисе | gpt-6.1-sol | claude-opus-5-5 |
| OpenAI | /api/v1/chat/completions | /api/v1/chat/completions |
| Anthropic | Не указан | /api/v1/messages |
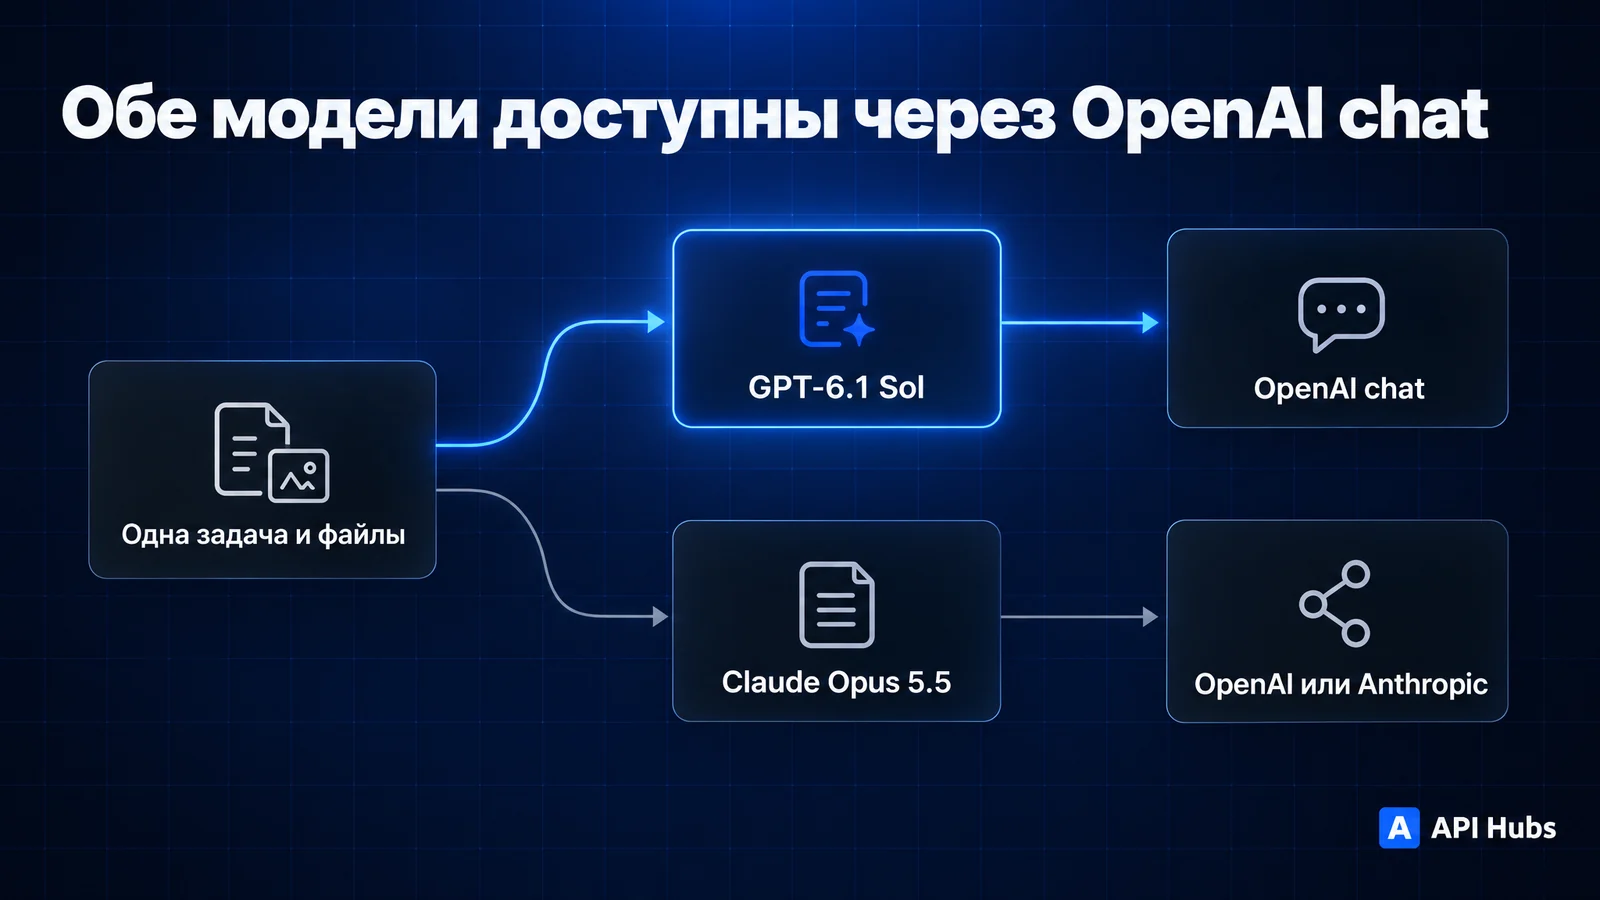
Формат описан в документации OpenAI-протокола. Минимальные запросы сверены со схемой; как платный тест качества они не выполнялись и условия внешнего Max-бенчмарка не воспроизводят.
curl https://api.apihubs.ru/api/v1/chat/completions -H "Authorization: Bearer $API_KEY" -H "Content-Type: application/json" -d '{"model":"gpt-6.1-sol","messages":[{"role":"user","content":"Предложи минимальный тест для повторного callback платежа."}],"max_tokens":1024}'curl https://api.apihubs.ru/api/v1/chat/completions -H "Authorization: Bearer $API_KEY" -H "Content-Type: application/json" -d '{"model":"claude-opus-5-5","messages":[{"role":"user","content":"Предложи минимальный тест для повторного callback платежа."}],"max_tokens":1024}'
Для полезной пробы приложите обеим моделям одинаковый падающий тест и связанные файлы. Примените предложенное исправление и запустите тесты. Учитывайте все оплаченные попытки до принятого патча. Официальные страницы Sol и Opus описывают возможности продуктов разработчиков; их инструменты не следует автоматически ожидать у этого endpoint.
Частые вопросы
Что первым попробовать для сложного кода?
Opus выше в двух приведённых кодовых тестах. Проверьте его на своём исправлении и сравните с Sol по проходящим тестам и полному расходу.
Sol всегда дешевле готового результата?
Обычные ставки ниже. Число попыток, длина ответа, кеш и повышенный тариф длинного контекста могут изменить итог.
Эти результаты измерены на вашем API?
Приведены внешние измерения с названными настройками и источниками. Они не устанавливают скорость или качество маршрутизации API Hubs.
Можно использовать один OpenAI-клиент?
Обе модели указаны в каталоге с этим протоколом. У Opus дополнительно есть Messages с отдельным форматом запроса и ответа.
- llm
- benchmarks
- pricing
Попробуйте со своим ключом
Выберите модель в каталоге API Hubs, проверьте цену и попробуйте её в браузере или через API.
Читать дальше
 СравнениеGPT-6 Astra vs Claude Fable 5.1: бенчмарки и ценаСравниваем GPT-6 Astra и Claude Fable 5.1 по бенчмаркам и Agent Arena: погрешность оценок, тарифы в coin и два сценария кеширования входа.·4 мин чтения
 СравнениеGPT-6.1 Sol vs Claude Sonnet 5.5: бенчмарки и ценаСравниваем GPT-6.1 Sol и Claude Sonnet 5.5 по бенчмаркам Artificial Analysis, Agent Arena, протоколам API и цене одинаковой задачи в coin.·6 мин чтения
 СравнениеKling 4.0 или Seedance 2.5: звук, референсы и ценаСравниваем Kling 4.0 и Seedance 2.5: цена десяти секунд в 720p и 1080p, генерация звука, исходное видео и бюджет нескольких попыток.·4 мин чтения