Сравнение
GPT-6.1 Sol vs Claude Sonnet 5.5: бенчмарки и цена
Сравниваем GPT-6.1 Sol и Claude Sonnet 5.5 по бенчмаркам Artificial Analysis, Agent Arena, протоколам API и цене одинаковой задачи в coin.
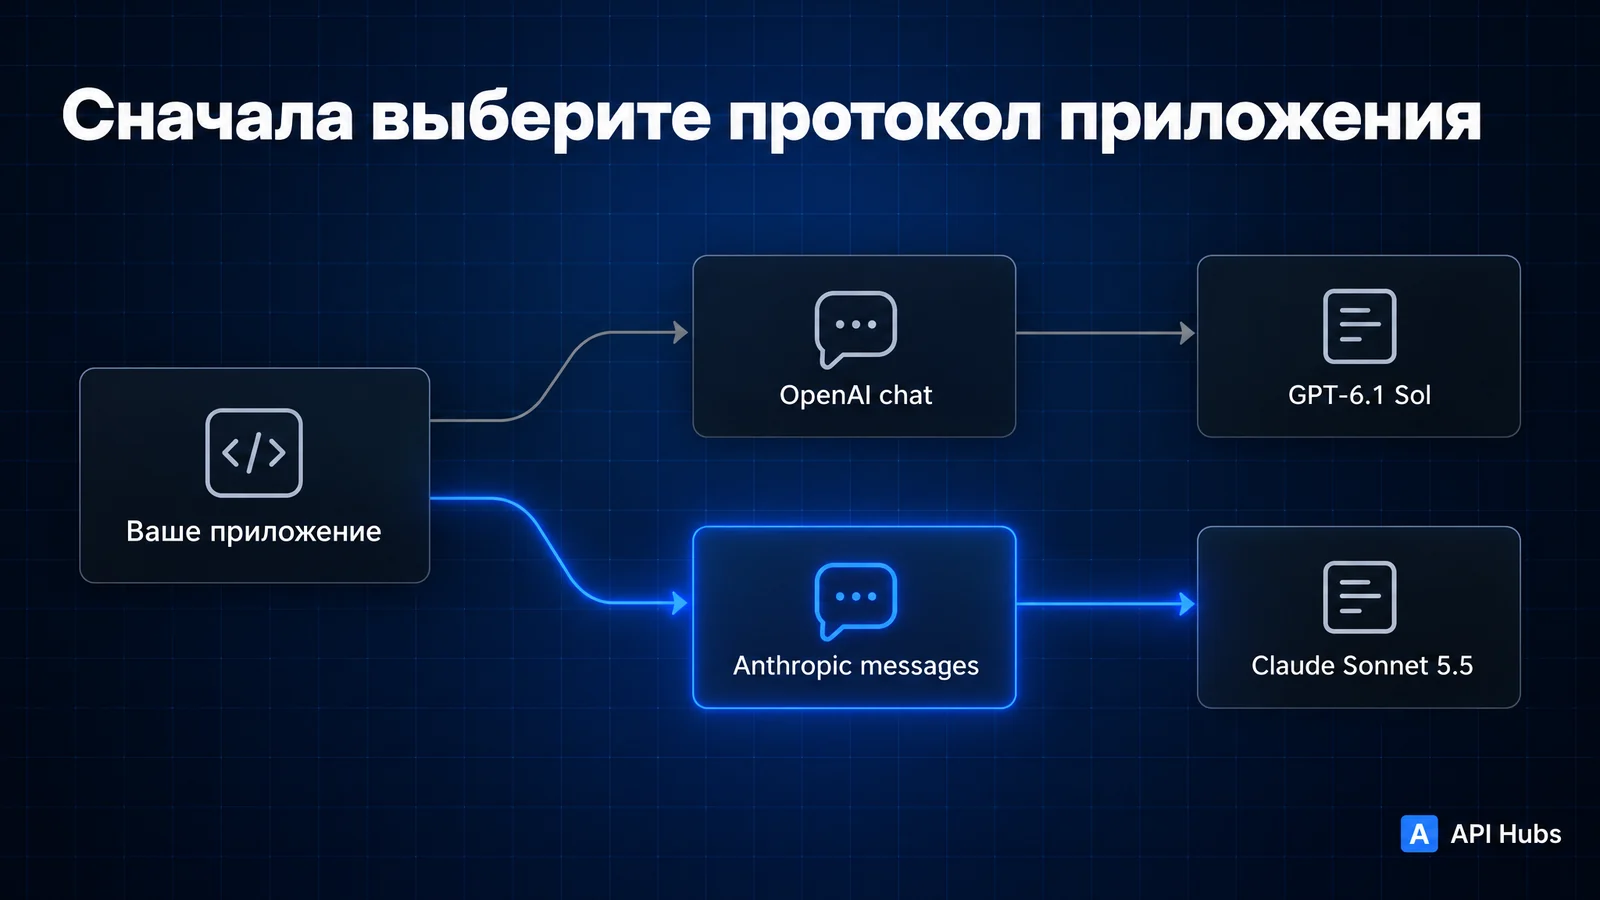
На API Hubs проверка кода с условными 20 000 входных и 2 000 выходных токенов обходится в 0,027 coin на Claude Sonnet 5.5 и 0,054 coin на GPT-6.1 Sol. Для подключения важен протокол: Sonnet здесь работает через Anthropic Messages, Sol — через OpenAI Chat Completions. Выбирать стоит по стоимости принятого результата и совместимости с вашим приложением.
Обновлено 5 ноября 2026 года: добавлены результаты Artificial Analysis и Agent Arena, условия тестов, интервалы и снимок исходных данных.
Почему эти модели стоит сравнить?
Sonnet 5.5 вышел 28 сентября 2026 года. Anthropic описывает его как вариант для ограниченных по объёму задач, исправления ошибок и повседневной работы. На следующий день OpenAI добавила GPT-6.1 Sol в API для сложных задач программирования и профессиональной работы. Обе модели присутствуют в текущем каталоге API Hubs.
По опубликованным данным Sonnet выше в Terminal-Bench 4.0, при этом общий индекс совпадает. Ниже разделяем внешние оценки качества и тарифы API Hubs; затем показываем, как проверить собственную задачу.
Что показывают опубликованные бенчмарки?
Источник таблицы — Artificial Analysis, проверено 5 ноября 2026 года. Конфигурации: GPT-6.1 Sol — Max, Claude Sonnet 5.5 — Max, Default Fallback. Сохраняем обозначение fallback из источника: это часть измеренной конфигурации, которую нельзя автоматически приравнять к нашему API.
| Метрика и единица | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Intelligence Index v5.0.1 · баллы | 55 | 55 |
| Terminal-Bench 4.0 · % | 56 | 64 |
| FrontierCode 2.0 · % | 41 | 42 |
| AA-Briefcase v1.1 · Elo | 1555 | 1813 |
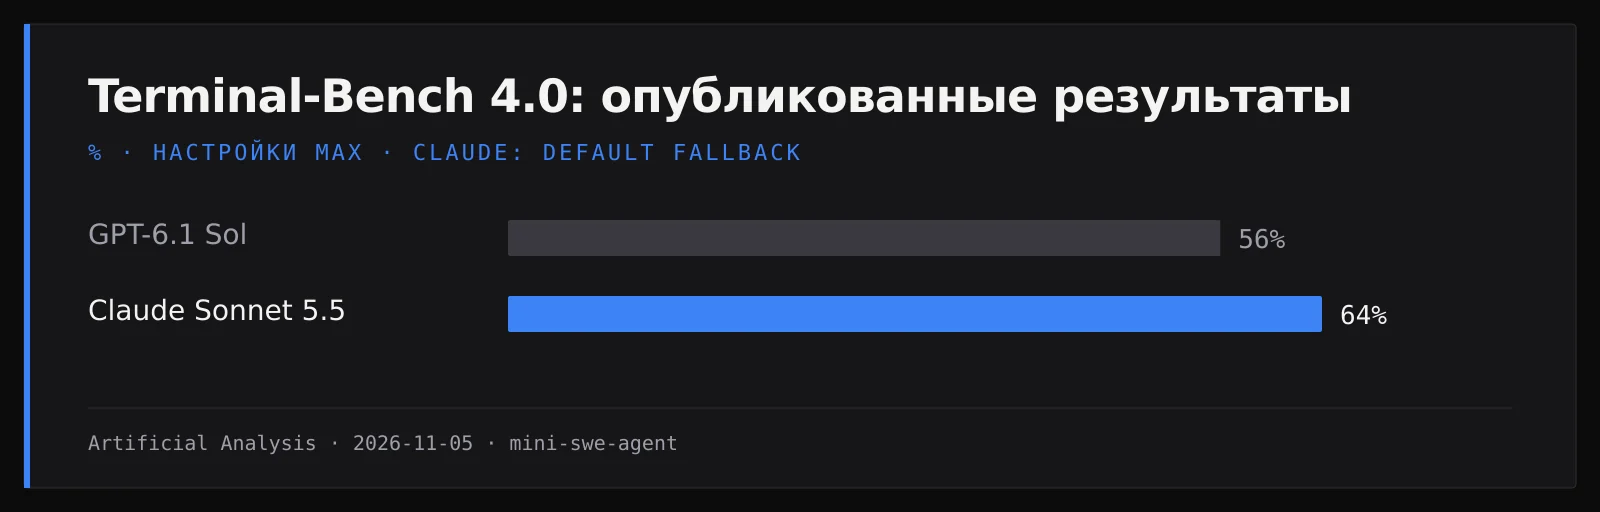
Terminal-Bench 4.0 проверяет работу в терминале: 66 задач, mini-swe-agent, три повтора, средний pass@1; для зачёта должны пройти все проверки. FrontierCode 2.0 использует 132 задачи, три попытки и Stirrup: оценка учитывает скрытые тесты и рубрику с LLM-судьёй. Проценты этих двух тестов измеряют разные задания и способы оценки.
Методика Intelligence Index v5.0.1 объединяет девять оценок: баллы индекса не означают процент правильных ответов. Max обозначает максимальный режим конкретной модели, а не одинаковый бюджет вычислений. В таблице сохранено округление источника; доверительные интервалы отдельных результатов и точные даты запусков на странице сравнения не приведены. Дата выше — дата проверки публикации.
AA-Briefcase v1.1 проверяет 91 задачу подготовки рабочих файлов; итоговый Elo объединяет рубрику, аналитическое качество и оформление. Это не процент успешных исправлений кода.
При равном общем индексе Sonnet выше в Terminal-Bench и AA-Briefcase. Разница FrontierCode — один округлённый процентный пункт; без интервалов нельзя объявить её надёжным преимуществом. Выбор для ревью кода требует проверки на дефектах вашего проекта.
Что добавляет Agent Arena?
Agent Arena, таблица от 4 ноября 2026 года, даёт отдельную оценку на реальных сессиях:
| Модель | Net Improvement, п. п. · оценка ± полуширина 95% ДИ | Сессии |
|---|---|---|
| GPT-6.1 Sol (Max) | 12,51 ± 1,11 | 30 285 |
| Claude Sonnet 5.5 (Max) | 15,42 ± 2,78 | 8 596 |
Методика Arena оценивает эффект выбора модели по сигналам сессий с рандомизацией компонентов. Net Improvement — оценка эффекта, а не доля выполненных задач. Не складывайте её с процентами Terminal-Bench.
Интервалы Sol и Sonnet перекрываются; порядок строк не доказывает устойчивое преимущество на вашей нагрузке. Это внешние измерения, а не тест API Hubs или его маршрутизации. Снимок цифр и условий позволяет проверить таблицы позднее.
Какой endpoint нужен вашему приложению?
Каталог, проверенный 5 ноября 2026 года, указывает разные протоколы:
| Параметр | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| ID модели | gpt-6.1-sol | claude-sonnet-5-5 |
| Протокол | OpenAI | Anthropic |
| Endpoint | /api/v1/chat/completions | /api/v1/messages |
| Базовые поля | model, messages | model, messages, обязательный max_tokens |
| Формат результата | Chat completion | Anthropic message |
Для приложения с готовым OpenAI-клиентом первая проба Sol требует меньше изменений в обработке ответа. Если ваш код уже разбирает блоки Anthropic Messages, начните с Sonnet 5.5. Просто заменить ID модели в прежнем запросе недостаточно.
Сверьте интеграцию с документацией OpenAI-протокола и Anthropic-протокола. Наличие модели в каталоге не означает, что API автоматически повторяет инструменты, подписку или весь интерфейс её разработчика. Например, официальная документация Sol описывает инструменты Responses API; из этого нельзя вывести их наличие в здешнем Chat Completions.
Сколько стоит одинаковая нагрузка в coin?
Цены API Hubs на 5 ноября 2026 года, в coin за миллион токенов. Это тарифы сервиса, отдельно от прямых тарифов разработчиков моделей.
| Вид токенов | Sonnet 5.5 | GPT-6.1 Sol, обычный контекст |
|---|---|---|
| Вход без кеша | 0,90 | 1,80 |
| Выход | 4,50 | 9,00 |
| Чтение кеша | 0,09 | 0,18 |
| Запись кеша | 1,125 | 2,25 |
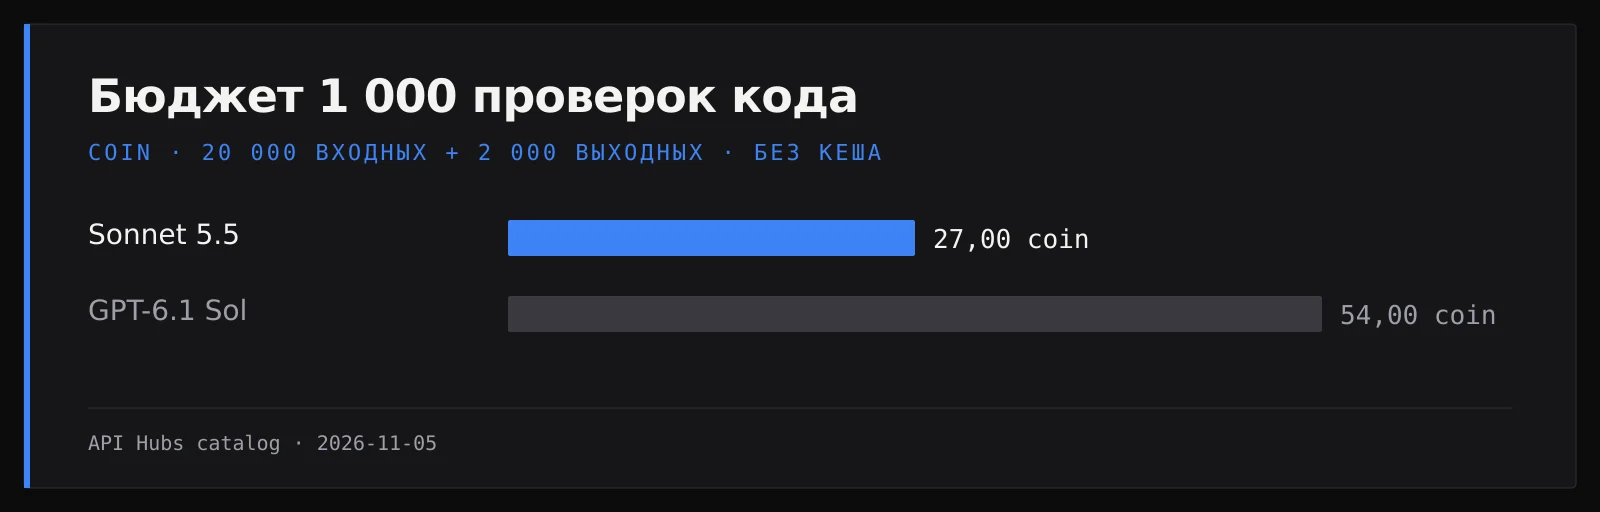
Возьмём расчётный сценарий: одна задача содержит 20 000 входных и 2 000 оплачиваемых выходных токенов, кеш не используется. Для Sonnet получаем 0,02 × 0,90 + 0,002 × 4,50 = 0,027 coin. Для Sol: 0,02 × 1,80 + 0,002 × 9 = 0,054 coin.
Тысяча таких задач стоит 27 или 54 coin соответственно. Равное число токенов задано для сравнения арифметики. В реальной работе модели могут написать ответы разной длины, использовать дополнительные оплачиваемые токены рассуждений или потребовать повторный запрос. Сумму пополнения и цену отдельного запроса также считайте отдельно; фиксированный курс coin к рублю здесь не предполагается.
Что меняется у Sol после 272 000 входных токенов?
В каталоге есть повышенный тариф при превышении 272 000 входных токенов: 3,60 coin за миллион входных и 15,75 coin за миллион выходных. Условная задача с 300 000 входных и 10 000 выходных без кеша стоит 0,3 × 3,60 + 0,01 × 15,75 = 1,2375 coin.
Для Sonnet отдельный тариф длинного контекста в этом снимке не указан; по его ставкам те же условные объёмы дают 0,315 coin. Этот расчёт не гарантирует приём запроса произвольного размера. Проверьте ограничения сервиса, всю историю переписки и фактический объём входа перед отправкой большого проекта. Исходные ставки сохранены в снимке тарифов.
Как устроить полезную пробу на своём коде?
Возьмите исправление, для которого знаете ожидаемое поведение: повторный callback платежа, проверку доступа или обработку таймаута. Передайте обеим моделям один diff и одинаковые связанные файлы. Пример задания:
Проверь только ошибки, появившиеся в этом diff. Дай не больше трёх замечаний. Для каждого укажи файл, нарушенное поведение, подтверждение из приложенного кода и минимальный способ воспроизведения. Если данных не хватает, назови недостающий файл или условие. Сторонние рефакторинги не предлагай.
Засчитывайте замечание, когда ошибку удалось воспроизвести. Записывайте расход всех попыток и время ручной проверки. Если модель дважды ссылается на несуществующий код, сначала сократите контекст или уточните задачу. Дополнительный запрос с тем же неясным вводом может повторить ошибку.
Минимальные примеры ниже сверены с публичной схемой. Они не запускались как платный сравнительный тест. Подставьте свой ключ с достаточным балансом:
curl https://api.apihubs.ru/api/v1/chat/completions \-H "Authorization: Bearer $API_KEY" \-H "Content-Type: application/json" \-d '{"model":"gpt-6.1-sol","messages":[{"role":"user","content":"Назови три проверки идемпотентности callback платежа."}],"max_tokens":1024}'curl https://api.apihubs.ru/api/v1/messages \-H "Authorization: Bearer $API_KEY" \-H "Content-Type: application/json" \-d '{"model":"claude-sonnet-5-5","max_tokens":1024,"messages":[{"role":"user","content":"Назови три проверки идемпотентности callback платежа."}]}'
Это синхронные ответы языковых моделей, поэтому получать медийный taskId для них не нужно. Сравните текст и фактический usage в соответствующем формате. Начните с модели, которая подходит существующему клиенту, а перед серией задач откройте актуальные цены.
Частые вопросы
Sonnet 5.5 всегда обходится вдвое дешевле Sol?
Его обычные ставки входа и выхода в этом каталоге вдвое ниже. Цена готового результата зависит от объёма оплаченных токенов и числа попыток.
Можно заменить название модели в OpenAI-запросе на Sonnet?
Каталог указывает для Sonnet Anthropic-протокол. Используйте /api/v1/messages и разбирайте ответ Messages, а не формат Chat Completions.
Как понять, какая модель лучше проверяет код?
Проверьте одинаковые задачи из своего проекта и воспроизведите найденные дефекты. Цены и убедительный стиль ответа сами по себе качество ревью не измеряют.
Включены ли кеш и длинный контекст в расчёт 0,027 coin?
Нет: это сценарий Sonnet с 20 000 входных и 2 000 выходных токенов без кеша. Чтение кеша, его создание и повышенный тариф Sol считаются отдельно.
- llm
- coding
- pricing
Попробуйте со своим ключом
Выберите модель в каталоге API Hubs, проверьте цену и попробуйте её в браузере или через API.
Читать дальше
 СравнениеGPT-6.1 Sol vs Claude Opus 5.5: бенчмарки и ценаСравниваем GPT-6.1 Sol и Claude Opus 5.5 по кодовым бенчмаркам, Agent Arena и тарифам в coin: методики тестов, цена задачи и выбор API.·4 мин чтения
 СравнениеGPT-6 Astra vs Claude Fable 5.1: бенчмарки и ценаСравниваем GPT-6 Astra и Claude Fable 5.1 по бенчмаркам и Agent Arena: погрешность оценок, тарифы в coin и два сценария кеширования входа.·4 мин чтения
 СравнениеKling 4.0 или Seedance 2.5: звук, референсы и ценаСравниваем Kling 4.0 и Seedance 2.5: цена десяти секунд в 720p и 1080p, генерация звука, исходное видео и бюджет нескольких попыток.·4 мин чтения