Сравнение
GPT-6 Astra vs Claude Fable 5.1: бенчмарки и цена
Сравниваем GPT-6 Astra и Claude Fable 5.1 по бенчмаркам и Agent Arena: погрешность оценок, тарифы в coin и два сценария кеширования входа.
GPT-6 Astra выше в кодовых тестах Artificial Analysis, Claude Fable 5.1 — в AA-Briefcase. В Agent Arena доверительные интервалы перекрываются. По тарифам API Hubs Astra дешевле в расчёте без кеша, а Fable дешевле при условии, что 95% входа действительно оплачивается как чтение кеша. Выбор зависит от задачи и фактического расхода.
Что показывают опубликованные бенчмарки?
Источник таблицы — Artificial Analysis, проверено 5 ноября 2026 года. Конфигурации: GPT-6 Astra — Max, Claude Fable 5.1 — Max, Default Fallback. Сохраняем обозначение fallback из источника: это часть измеренной конфигурации, которую нельзя автоматически приравнять к нашему API.
| Метрика и единица | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Intelligence Index v5.0.1 · баллы | 57 | 49 |
| Terminal-Bench 4.0 · % | 59 | 52 |
| FrontierCode 2.0 · % | 42 | 32 |
| AA-Briefcase v1.1 · Elo | 1569 | 1669 |
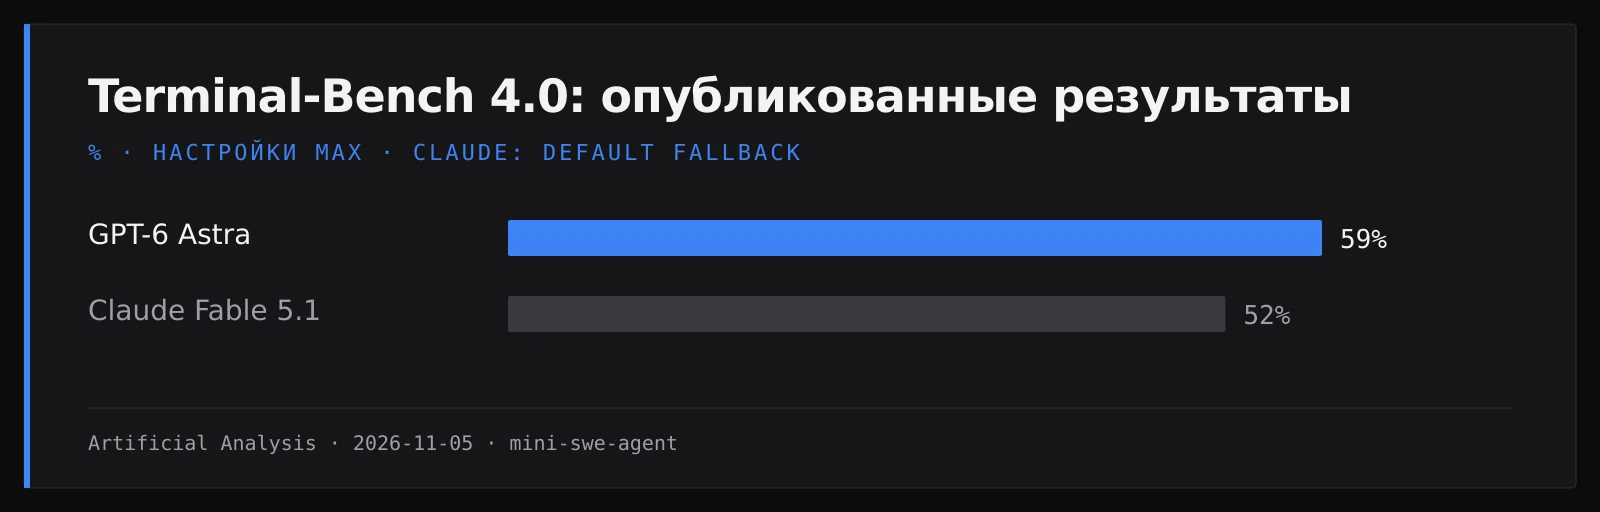
Terminal-Bench 4.0 проверяет работу в терминале: 66 задач, mini-swe-agent, три повтора, средний pass@1; для зачёта должны пройти все проверки. FrontierCode 2.0 использует 132 задачи, три попытки и Stirrup: оценка учитывает скрытые тесты и рубрику с LLM-судьёй. Проценты этих двух тестов измеряют разные задания и способы оценки.
Методика Intelligence Index v5.0.1 объединяет девять оценок: баллы индекса не означают процент правильных ответов. Max обозначает максимальный режим конкретной модели, а не одинаковый бюджет вычислений. В таблице сохранено округление источника; доверительные интервалы отдельных результатов и точные даты запусков на странице сравнения не приведены. Дата выше — дата проверки публикации.
AA-Briefcase v1.1 проверяет 91 задачу подготовки рабочих файлов; итоговый Elo объединяет рубрику, аналитическое качество и оформление. Это не процент успешных исправлений кода.
Astra выше в кодовых тестах и общем индексе, Fable — в AA-Briefcase, где шкала выражена в Elo. Для кодового агента первым кандидатом выглядит Astra; для офисной задачи с документами стоит проверить обе модели по своему критерию приёмки. Общий индекс не заменяет профиль задачи.
Что добавляет Agent Arena?
Agent Arena, таблица от 4 ноября 2026 года, даёт отдельную оценку на реальных сессиях:
| Модель | Net Improvement, п. п. · оценка ± полуширина 95% ДИ | Сессии |
|---|---|---|
| GPT-6 Astra (Max) | 14,70 ± 2,07 | 15 475 |
| Claude Fable 5.1 (Max) | 13,86 ± 1,87 | 17 518 |
Методика Arena оценивает эффект выбора модели по сигналам сессий с рандомизацией компонентов. Net Improvement — оценка эффекта, а не доля выполненных задач. Не складывайте её с процентами Terminal-Bench.
У Astra и Fable интервалы перекрываются: 14,70 против 13,86 п. п. сами по себе не доказывают уверенного победителя. Это внешние измерения, а не тест API Hubs или его маршрутизации. Снимок цифр и условий позволяет проверить таблицы позднее.
Когда кеш меняет сравнение цены?
Каталог проверен 5 ноября 2026 года. Ниже тарифы API Hubs в coin за миллион токенов, отдельно от долларовых затрат операторов бенчмарков.
| Вид токенов | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Вход без кеша | 8,00 | 10,00 |
| Выход | 40,00 | 50,00 |
| Чтение кеша | 0,80 | 0,25 |
| Запись кеша | 10,00 | 12,50 |
Зададим 100 000 входных и 1 000 оплачиваемых выходных токенов на запрос:
| Условие расчёта | Astra, coin | Fable, coin |
|---|---|---|
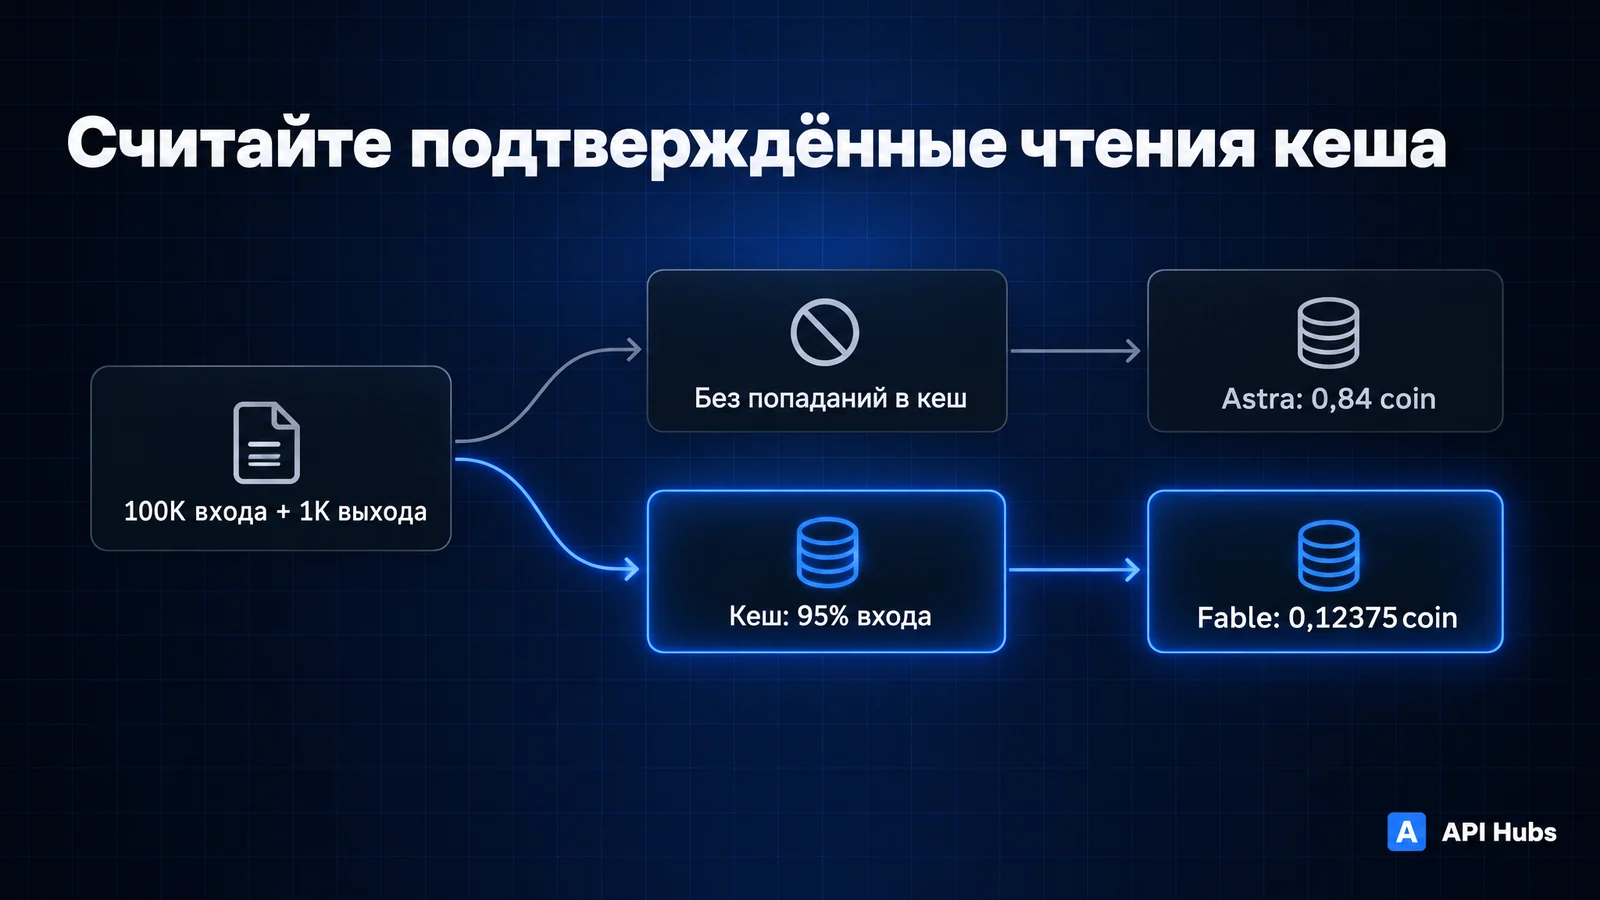
| Все 100 000 входных без кеша | 0,84 | 1,05 |
| 95 000 чтения кеша + 5 000 без кеша; запись не включена | 0,156 | 0,12375 |
Вторая строка для Astra: 0,095 × 0,80 + 0,005 × 8 + 0,001 × 40. Для Fable: 0,095 × 0,25 + 0,005 × 10 + 0,001 × 50. Две входные категории делят одни и те же 100 000 токенов; чтение кеша не добавляется поверх полного входа.
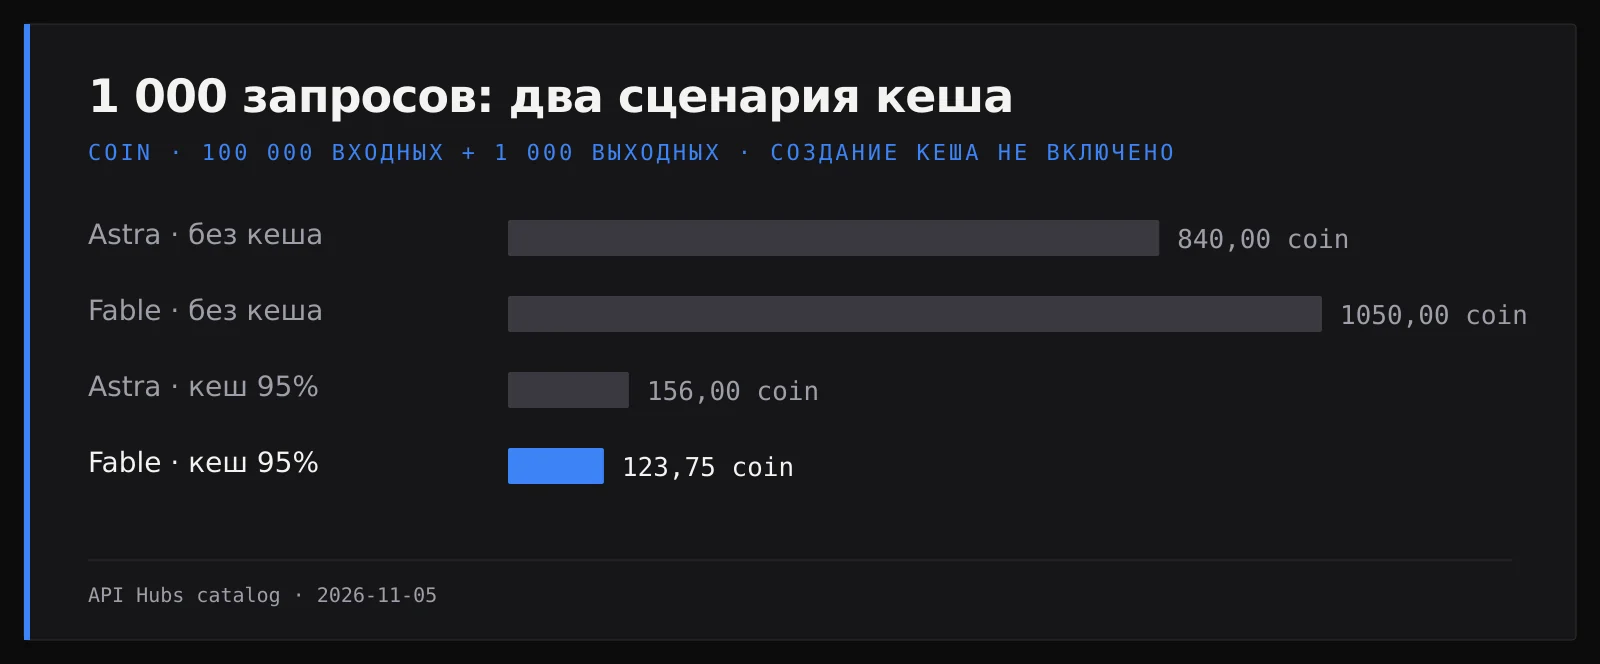
За тысячу запросов без кеша получаются 840 и 1050 coin. Если каждый запрос содержит 95% оплачиваемого чтения кеша и не создаёт новых записей, — 156 и 123,75 coin. Это расчёт условий, а не измеренная доля попаданий в кеш. Пересчёт в рубли здесь не задан.
Что проверить перед большим пакетом документов?
Постоянная вводная часть может повторяться, но первая запись, промахи, срок хранения и изменения начала запроса влияют на расход. Разработчики отдельно описывают кеширование OpenAI и Anthropic. Из этих описаний нельзя вывести, что все настройки доступны через этот API или что кеш переносится между моделями.
Сверьте категории в фактическом usage и списаниях. Разный объём выхода и оплачиваемые рассуждения способны изменить итог. Пример ограничен входом 100 000 токенов: он не устанавливает тариф и допустимый размер для любого контекста. Ставки сохранены в датированном снимке, текущие значения — на странице цен.
Какой ID указать в запросе?
Для Astra нужен gpt-6-astra. Для Fable 5.1 — claude-fable-5.1, с точкой перед последней цифрой. Обе модели указаны с OpenAI Chat Completions; Fable также поддерживает Anthropic Messages. Формат описан в документации OpenAI-протокола.
Примеры сверены с публичной схемой, как платное сравнение не запускались. Они показывают синтаксис, а не воспроизводят агентную среду и Max-настройки бенчмарка.
curl https://api.apihubs.ru/api/v1/chat/completions -H "Authorization: Bearer $API_KEY" -H "Content-Type: application/json" -d '{"model":"gpt-6-astra","messages":[{"role":"user","content":"Какие подтверждения нужны для проверки утверждения в длинном отчёте?"}],"max_tokens":1024}'curl https://api.apihubs.ru/api/v1/chat/completions -H "Authorization: Bearer $API_KEY" -H "Content-Type: application/json" -d '{"model":"claude-fable-5.1","messages":[{"role":"user","content":"Какие подтверждения нужны для проверки утверждения в длинном отчёте?"}],"max_tokens":1024}'
Для пробы на документах передайте одинаковые файлы и запросите таблицу утверждений с цитатами и страницами. Проверьте ссылки по оригиналу и посчитайте неподтверждённые утверждения. Для кода критерием будут тесты. Официальные страницы Astra и Fable описывают продукты разработчиков; их встроенные инструменты не становятся частью этого endpoint автоматически.
Частые вопросы
Astra лучше во всех тестах?
В приведённых кодовых тестах и общем индексе выше Astra, в AA-Briefcase — Fable. Интервалы Agent Arena перекрываются, поэтому одних точечных оценок для уверенного победителя мало.
Fable дешевле для повторяющихся документов?
В сценарии с 95% оплачиваемого чтения кеша — да. На фактическую цену влияют записи кеша, промахи, выходные токены и повторы.
Можно взять стоимость задачи прямо из рейтинга?
Операторы тестов используют свои задачи, настройки и тарифы. Для бюджета на API Hubs используйте ставки сервиса и собственный расход.
Как записать ID Fable 5.1?
В этом API нужен claude-fable-5.1. Обе модели работают с OpenAI-протоколом; Fable дополнительно указан с Anthropic Messages.
- llm
- benchmarks
- pricing
Попробуйте со своим ключом
Выберите модель в каталоге API Hubs, проверьте цену и попробуйте её в браузере или через API.
Читать дальше
 СравнениеGPT-6.1 Sol vs Claude Opus 5.5: бенчмарки и ценаСравниваем GPT-6.1 Sol и Claude Opus 5.5 по кодовым бенчмаркам, Agent Arena и тарифам в coin: методики тестов, цена задачи и выбор API.·4 мин чтения
 СравнениеGPT-6.1 Sol vs Claude Sonnet 5.5: бенчмарки и ценаСравниваем GPT-6.1 Sol и Claude Sonnet 5.5 по бенчмаркам Artificial Analysis, Agent Arena, протоколам API и цене одинаковой задачи в coin.·6 мин чтения
 СравнениеKling 4.0 или Seedance 2.5: звук, референсы и ценаСравниваем Kling 4.0 и Seedance 2.5: цена десяти секунд в 720p и 1080p, генерация звука, исходное видео и бюджет нескольких попыток.·4 мин чтения